Модульный ЦОД для ИИ: от мощности до запуска
Модульный ЦОД для ИИ — это комплекс из вычислительного оборудования, электропитания, охлаждения, связи и систем контроля, собранный из согласованных блоков. Его рассчитывают под конкретную нагрузку: обучение моделей, корпоративный инференс, GPU-облако или несколько этих задач. Главный параметр такого проекта — сколько полезной работы кластер выполняет в доступном энергетическом и тепловом бюджете.
Установка нескольких GPU-серверов и строительство готовой площадки решают разные задачи. Сервер может подходить по ускорителям и памяти, но оказаться несовместимым с питанием стойки, водяным контуром или сервисными проходами. Поэтому выбирать модульный центр обработки данных стоит от рабочей нагрузки к инфраструктуре: сначала определить требования приложения, затем конфигурацию серверов и только после этого — устройство площадки.
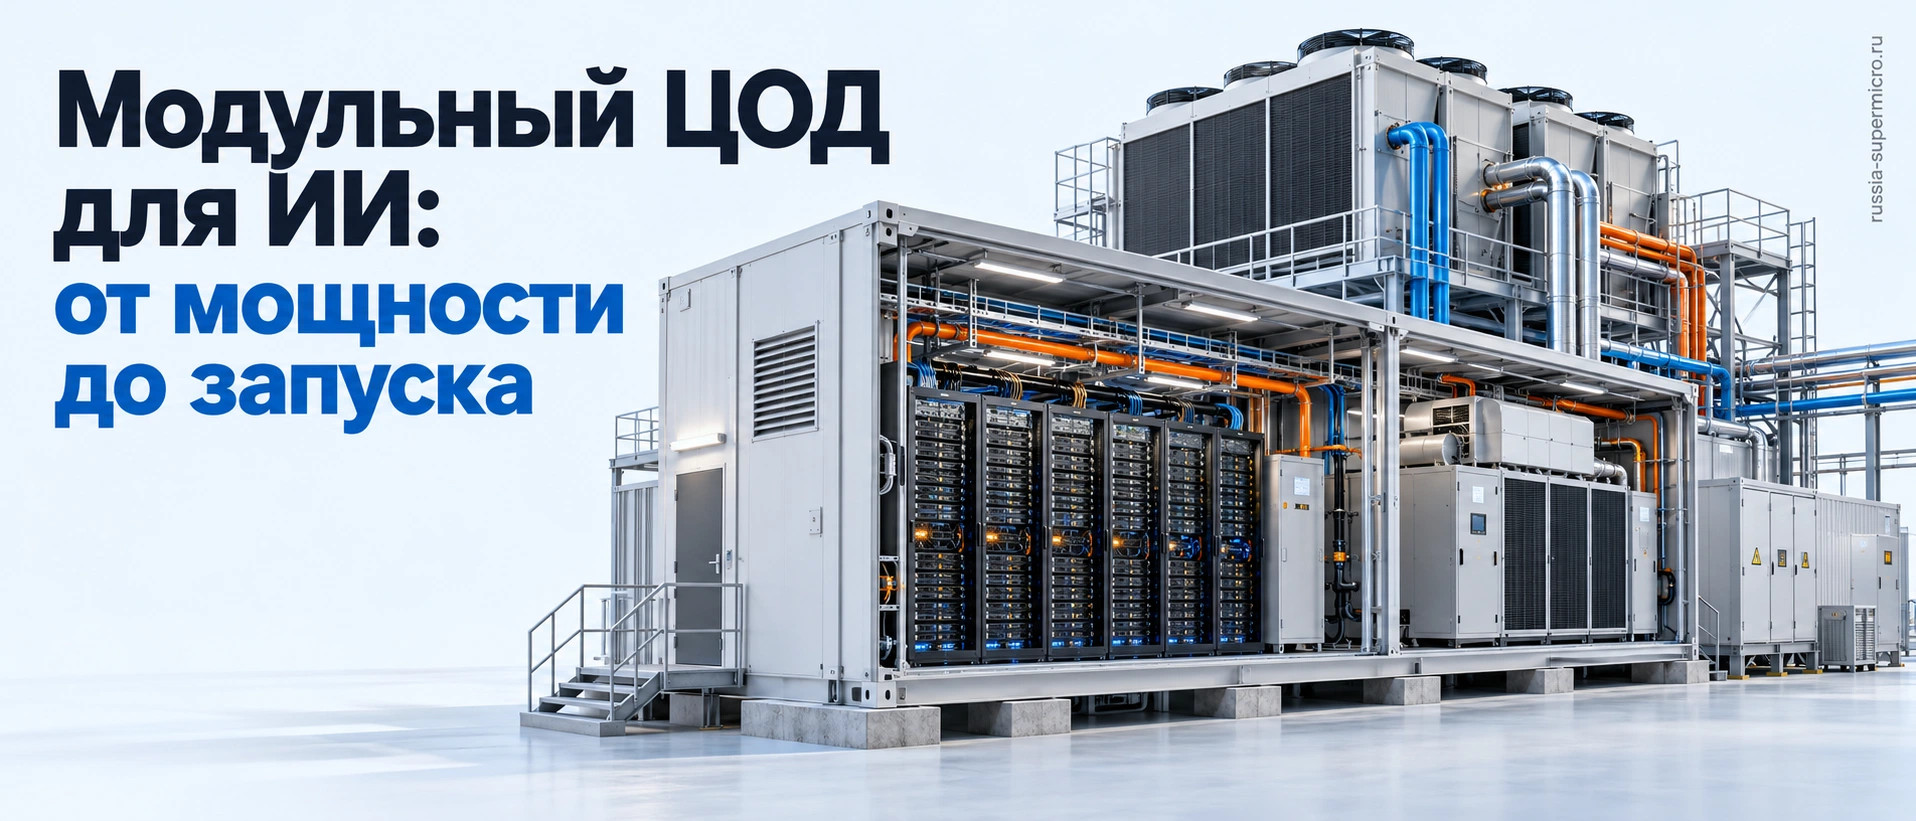
Практическую логику такого подхода хорошо раскрывает проект DigiPowerX с оборудованием Supermicro и ускорителями NVIDIA Blackwell. Разберём его архитектуру, а затем пройдём весь путь подготовки собственного проекта: от киловатт и CDU до приёмки и стоимости полезного GPU-часа.
Что такое модульный ЦОД и чем он отличается от контейнерного
Модульность описывает способ построения объекта. Вычислительный зал, электротехнический блок, охлаждение и другие подсистемы можно изготовить и проверить отдельно, а затем объединить на площадке. Контейнерное исполнение описывает конструкцию оболочки. Модульный ЦОД может состоять из нескольких контейнеров, а может использовать заводские блоки другой формы и размера.
Для ИИ важна возможность добавлять законченную порцию ресурсов: серверные узлы, сеть, электрическую мощность и отвод тепла. Дополнительный контейнер с пустыми стойками не увеличит производительность, если исчерпан ввод питания или общий теплообменник. Поэтапное расширение закладывают одновременно в вычислительную и инженерную части проекта.
| Часть комплекса | Что входит | Что нужно согласовать |
|---|---|---|
| Вычислительный модуль | GPU- и CPU-серверы, стойки, локальные накопители | Габариты, масса, доступ к обслуживаемым узлам, максимальная мощность |
| Электропитание | Вводы, распределение, ИБП, PDU или шинопроводы | Рабочие и аварийные режимы, селективность, схема резервирования |
| Охлаждение | CDU, коллекторы, трубопроводы, теплоотвод, воздушный контур | Температура, расход, давление, теплоноситель, остаточное тепло |
| Связь и хранение | Вычислительная сеть, сеть управления, СХД, внешние каналы | Пропускная способность, задержка, резервирование и разделение доступа |
| Управление и безопасность | Мониторинг, контроль доступа, датчики, аварийная автоматика | Ответственность систем, журналы событий и действия при отказах |
При формировании спецификации полезно разделить инфраструктуру ЦОД и оборудование, которое она обслуживает. Это помогает проверить комплектность: какие элементы входят в поставку стойки, какие поставляет инженерный подрядчик и какие заказчик должен подготовить заранее.
Как устроен проект DigiPowerX с серверами Supermicro
DigiPowerX развивает NeoCloudz как платформу выделенных GPU-вычислений. В её аппаратной основе — системы Supermicro с NVIDIA B200 и B300, жидкостное охлаждение и программные средства управления ресурсами. Предприятие может пользоваться вычислениями на площадке оператора либо развернуть подходящий комплекс у себя. Выделенный bare-metal ресурс означает физический сервер для согласованного использования; правила доступа, изоляции и эксплуатации всё равно задаются отдельно.
В одном из вариантов проекта стойка объединяет восемь серверов с восемью GPU в каждом — всего 64 ускорителя. Вместе с вычислительной частью предусмотрены коммутаторы и CDU класса 250 кВт. Эта цифра характеризует холодопроизводительность блока при определённых условиях работы, а не электрическое потребление стойки.
«Мы рассматриваем Supermicro как партнёра по проектированию».
Технический директор DigiPowerX, интервью Supermicro, октябрь 2026 года. Перевод с английского.
Ценность такого взаимодействия — в согласовании серверов, механики, питания, связи и обслуживания ещё до установки. Для заказчика это означает необходимость проверять весь проект, а не ограничиваться перечнем ускорителей. Комплект оборудования должен соответствовать и бизнес-задаче, и условиям площадки.
В разобранном примере IT-модуль имеет размеры примерно 40 × 20 футов: это около 12,2 × 6,1 м, или 74 м². Ориентир для комплекса порядка мегаватта — до 5000 квадратных футов, то есть около 465 м². Разница объясняется инженерными блоками и общей компоновкой. Эти размеры относятся к конкретному примеру DigiPowerX; переносить их на любой климат, участок и схему резервирования нельзя.
Какие GPU-серверы можно использовать в таком комплексе
В проекте применяются разные вычислительные платформы: для обучения, инференса, управляющих сервисов и хранения. Одинаковое число GPU не делает два сервера взаимозаменяемыми. Значение имеют память ускорителей, топология связей, система охлаждения, сетевые интерфейсы и поддерживаемое ПО.
| Платформа | Основные аппаратные особенности | Что учитывать при проектировании |
|---|---|---|
| Supermicro SYS-422GA-NBRT-LCC | 4U, два Intel Xeon 6900 с P-cores, восемь NVIDIA B200, 180 ГБ HBM3e на GPU | Полная интеграция жидкостной стойки, совместимые питание, сеть и сервис |
| Supermicro SYS-422GS-NB3RT-ALC | 4U, два Intel Xeon 6700 с P-cores, восемь NVIDIA B300, 288 ГБ HBM3e на GPU | Жидкостное охлаждение, конфигурация внешней сети и совместимость программного стека |
| Supermicro ASG-1115S-NE316R | Платформа хранения 1U, используемая в инфраструктуре проекта | Рабочий набор данных, профиль чтения и записи, отказоустойчивость и резервное копирование |
У восьми B200 суммарный физический объём HBM3e составляет 1440 ГБ, у восьми B300 — 2304 ГБ. Рост ёмкости равен 60%. Из этого не следует ускорение приложения на 60%: результат зависит от модели, точности вычислений, параллелизма и характера обмена. Совокупную память нескольких GPU также нельзя безусловно считать одним обычным буфером: размещение модели и данных управляется программным стеком.
Подбор GPU-серверов Supermicro начинается с того, какие модели предстоит запускать и сколько одновременных задач нужно обслуживать. Для инференса фиксируют длину контекста, число сессий и допустимое время ответа. Для обучения — размер модели, оптимизатор, точность и способ распределения вычислений. Эти параметры определяют потребность в памяти и сети гораздо точнее, чем общее пожелание «мощный сервер для ИИ».
Модульный ЦОД: сколько киловатт требуется для ИИ-кластера
В расчёте необходимо различать мощность серверов, всей ИТ-нагрузки и объекта целиком. К серверам добавляются сеть и хранение. За пределами ИТ-контура работают насосы, вентиляторы, охлаждающее оборудование, ИБП и другие инженерные системы. Номинал блока питания тоже не равен постоянному потреблению сервера: это предел его выходной мощности при заданных условиях.
Рассмотрим условный расчёт, а не готовую спецификацию. Пусть планируется восемь серверов, каждый с расчётной потребляемой мощностью 12 кВт в выбранной комплектации. Сеть и хранение добавляют ещё 8 кВт. Тогда ИТ-нагрузка равна 8 × 12 + 8 = 104 кВт.
| Показатель примера | Расчёт | Значение |
|---|---|---|
| Мощность вычислительных серверов | 8 × 12 кВт | 96 кВт |
| ИТ-нагрузка с сетью и хранением | 96 + 8 кВт | 104 кВт |
| Расчётная мощность объекта при PUE 1,20 | 104 × 1,20 | 124,8 кВт |
| Расчётная мощность объекта при PUE 1,40 | 104 × 1,40 | 145,6 кВт |
| Годовая энергия при постоянных 124,8 кВт | 124,8 × 8760 часов | 1 093 248 кВт·ч |
| Годовая энергия при постоянных 145,6 кВт | 145,6 × 8760 часов | 1 275 456 кВт·ч |
PUE — отношение энергии всего ЦОД к энергии ИТ-оборудования за один и тот же период и в согласованных границах измерения. Для предварительной оценки средней мощности его можно использовать как коэффициент. Подбор вводов, защит и аварийных режимов требует отдельного электротехнического расчёта: средний PUE не описывает пусковые процессы, пики и отказ одного плеча питания.
В приведённом примере разница между двумя сценариями составляет 182 208 кВт·ч в год. Денежный эффект получают умножением на собственный тариф с учётом структуры оплаты. Это расчёт чувствительности, а не обещание экономии конкретного оборудования. Фактическая энергия зависит от загрузки, температуры наружного воздуха и режима инженерных систем.
Как заложить резерв и не перепутать N+1 с 2N
Для каждого элемента нужно определить рабочую потребность N и последствия отказа. Схема N+1 добавляет резервный элемент к числу элементов, необходимых для нагрузки. Схема 2N предусматривает два комплекта полной необходимой мощности. Применять эти обозначения следует к конкретным подсистемам: ИБП, насосам, CDU, вводам или сетевым устройствам.
Два кабеля питания от одного общего незарезервированного источника не создают независимые энергетические пути. Так же и два насоса в одном CDU не устраняют все возможные отказы этого CDU. Проверка должна охватывать контроллеры, общие коллекторы, электропитание автоматики и возможность технического обслуживания.
Наличие резервных компонентов само по себе не означает сертификацию Tier III. Требования к доступности, обслуживаемости и подтверждению соответствия задают для объекта в целом. В техническом задании полезнее сначала описать допустимые события и время восстановления, а затем привязать к ним конкретную схему.
Как работает жидкостное охлаждение серверов через CDU
При прямом охлаждении Direct-to-Chip холодные пластины отводят тепло от выбранных компонентов. Теплоноситель циркулирует между сервером и CDU — блоком распределения охлаждающей жидкости. В жидкостно-жидкостной схеме теплообменник CDU передаёт тепло в контур площадки; жидкости двух контуров разделены. Дальше тепло отводит наружное оборудование, соответствующее климату и температурному графику проекта.
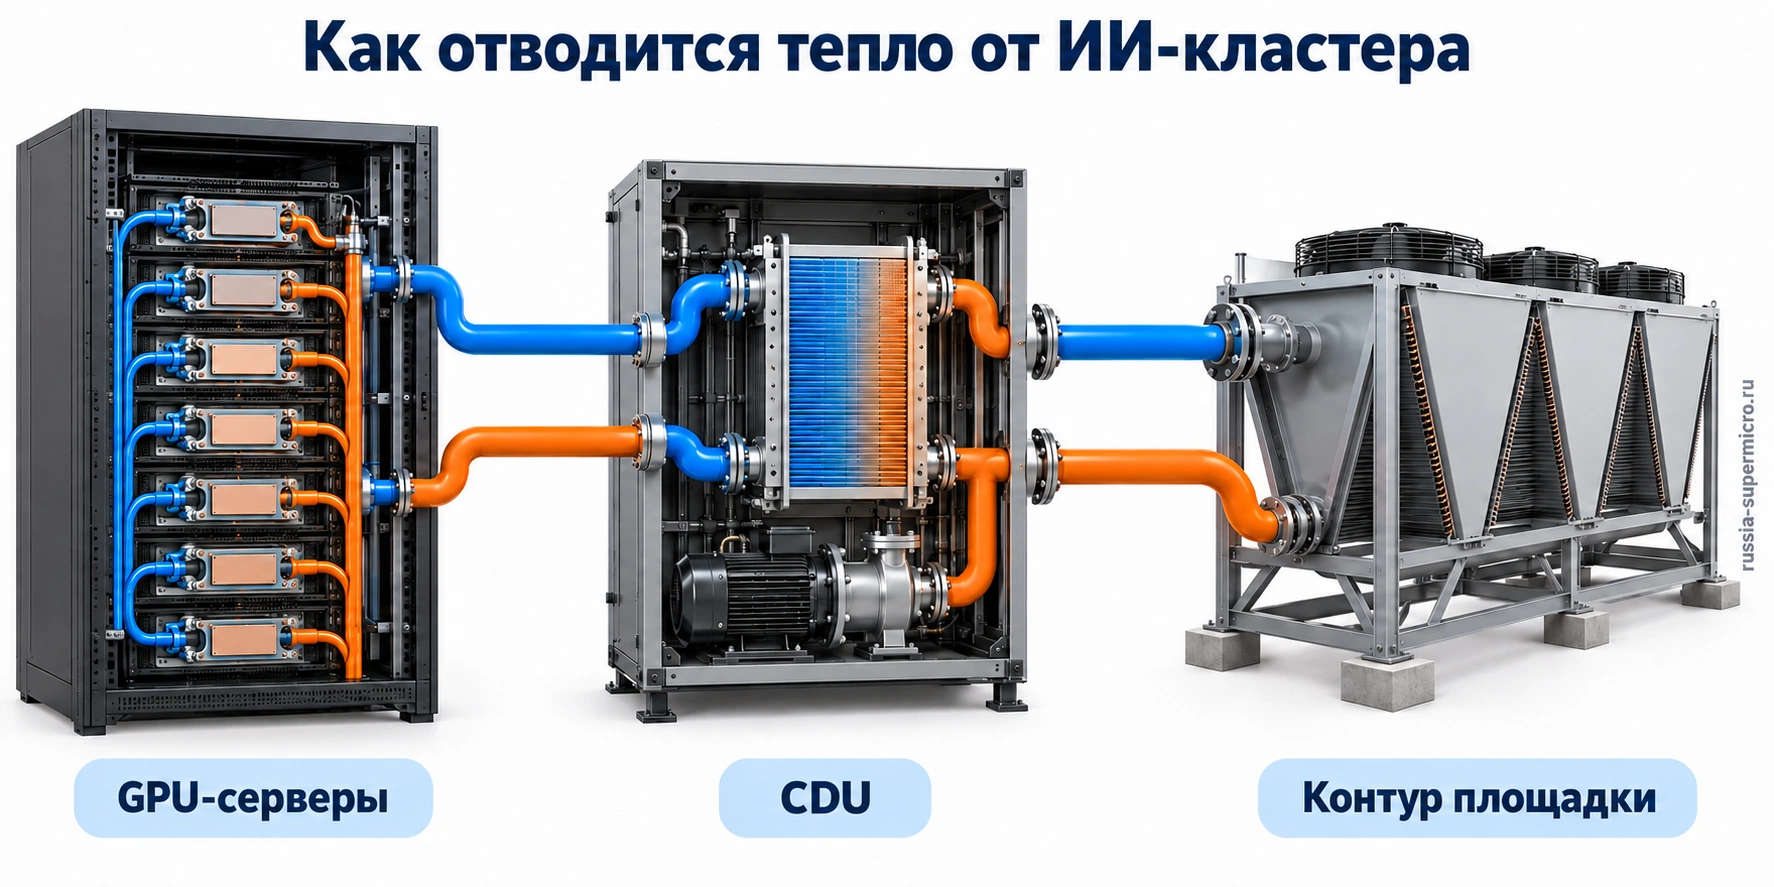
CDU не уничтожает тепло и не заменяет внешнюю систему теплоотвода. У жидкостно-воздушного решения конечным получателем тепла становится окружающий воздух помещения; это помещение также должно быть рассчитано на нагрузку. Для любой архитектуры необходимо проследить полный путь тепла до внешней среды.
Часть тепла может оставаться в воздушном контуре: его выделяют компоненты, не подключённые к холодным пластинам, и вспомогательное оборудование. Например, при условной ИТ-нагрузке 100 кВт и принятой для расчёта доле отвода жидкостью 85% остаётся 15 кВт воздушного тепла. Проектировать помещение как «полностью холодное» в таком случае ошибочно.
Для первичной проверки водяного контура используют тепловой баланс Q = ṁ × c × ΔT. Для чистой воды при принятой теплоёмкости около 4,18 кДж/(кг·К), тепловой нагрузке 100 кВт и разности температур 10 °C нужен массовый расход около 2,39 кг/с, приблизительно 144 л/мин при плотности около 1 кг/л. Это учебный пример: гликолевые смеси имеют другие свойства, а реальный расчёт включает гидравлическое сопротивление и требования оборудования.
- Температура: допустимый диапазон на входе и выходе, изменение по сезонам, контроль точки росы.
- Гидравлика: требуемый расход на узел, перепад давления, характеристики насосов, балансировка ветвей.
- Материалы: совместимость теплоносителя с металлами, уплотнениями, шлангами и теплообменником.
- Безопасность: датчики протечки, изоляция участка, безопасное отключение и действия дежурной смены.
- Обслуживание: доступ к фильтрам, насосам и соединениям, порядок замены узла и удаления воздуха.
Зачем GPU-кластеру отдельные сеть, хранение и управление
У распределённой ИИ-нагрузки есть несколько разных видов обмена. GPU внутри сервера взаимодействуют через предназначенную для этого топологию. Серверы обмениваются данными через внешнюю вычислительную сеть. Накопители отдают датасеты, контрольные точки и рабочие файлы. BMC и инженерная автоматика передают команды управления и аварийные сигналы.
Эти потоки стоит рассматривать отдельно, даже если часть физической сети общая. Иначе массовое чтение датасета или сохранение контрольной точки может влиять на работу управляющих сервисов. Требования к сетевому оборудованию определяются картой обмена: скорость портов, распределение трафика, допустимая переподписка и поведение при отказах.
Для системы хранения данных фиксируют полезную ёмкость, скорость параллельного чтения, размер файлов и время записи контрольной точки. Резервное копирование планируют отдельно от отказоустойчивого хранения. Восстановление должно возвращать не только модель, но и настройки запуска, права доступа и рабочие данные.
Мониторинг объединяет ИТ- и инженерную картины: потребление по стойкам, температуру и расход жидкости, состояние насосов, доступность серверов и фактическую производительность приложений. Временные метки журналов должны быть согласованы. Тогда рост задержки можно связать с температурным ограничением, сетевым событием или изменением нагрузки.
Сколько времени занимает запуск модульного ЦОД
Срок изготовления модулей и срок готовности объекта — разные интервалы. В интервью DigiPowerX обсуждается изготовление и отправка модулей в пределах четырёх–шести месяцев. Подключение мощности, подготовка основания, внешние коммуникации и согласования идут по собственному графику. Готовый модуль может прибыть раньше, чем площадка сможет принять нагрузку.
Вместо одной даты поставки нужен график с зависимостями: обследование, проектирование, заказ длинноциклового оборудования, заводские испытания, готовность площадки, логистика, монтаж, комплексная проверка и ввод в эксплуатацию. Для каждого этапа указывают владельца результата и документ, подтверждающий готовность.
Отдельно проверяют маршрут доставки, грузоподъёмность и место работы крана, основание, дренаж, снеговую и ветровую нагрузку, требования к шуму и обслуживанию. Размещение на свободной территории предприятия не делает её автоматически пригодной для ЦОД. Нужны электрическая мощность, связь и возможность безопасно эксплуатировать весь комплекс.
Из чего складывается цена модульного ЦОД для ИИ
Стоимость проекта состоит из вычислительного оборудования, инженерной инфраструктуры, подготовки площадки, интеграции и эксплуатации. Сравнивать два предложения можно только при одинаковых границах поставки. В одном могут быть предусмотрены наружный теплоотвод и пусконаладка, а в другом — только серверные стойки и CDU.
| Статья затрат | Что уточнить в предложении | Типичная причина расхождения смет |
|---|---|---|
| Серверы и сеть | Точные SKU, комплектация, кабели, оптика, лицензии | Сравниваются разные объёмы памяти, сети или сервиса |
| Питание и охлаждение | Рабочая мощность, резерв, наружное оборудование | Часть инженерных подсистем вынесена за границы поставки |
| Строительная готовность | Основание, вводы, трассы, разгрузка и монтаж | Подготовка площадки считается обязанностью заказчика |
| ПО и запуск | Управление, оркестрация, интеграция, испытания | Не учтены работы по переносу приложений и данным |
| Эксплуатация | Энергия, связь, обслуживание, запчасти и персонал | Занижены длительность владения или стоимость поддержки |
Удобная метрика для GPU-площадки — стоимость полезного GPU-часа. Её считают как полные затраты за выбранный период, делённые на число GPU, часы периода и долю полезной загрузки. Из знаменателя необходимо исключить время, когда ускорители заняты повторными неудачными задачами или не обслуживают полезную работу. Метод учёта загрузки должен быть одинаковым во всех сравниваемых вариантах.
Например, 64 GPU за обычный год дают 560 640 потенциальных GPU-часов. При условной полезной загрузке 70% остаётся 392 448 часов, при 35% — 196 224. При одинаковых полных затратах удельная стоимость во втором сценарии удваивается. Поэтому неопределённый спрос может влиять на экономику сильнее, чем небольшая разница в цене стойки.
Для сравнения с облаком собирают полную корзину: ускорители, CPU, память, хранение, трафик, поддержку и условия резервирования ресурса. Собственную площадку оценивают с амортизацией, стоимостью капитала, риском простоя и трудозатратами. Покупка выгодна при одних профилях нагрузки, аренда или поэтапное наращивание — при других; универсального срока окупаемости нет.
Что включить в техническое задание и программу приёмки
Техническое задание должно описывать проверяемый результат. Формулировка «кластер на 64 GPU» недостаточна: 64 ускорителя можно установить, но не получить нужную задержку ответа, скорость обучения или устойчивость сервиса. От аппаратного перечня переходят к измеримым критериям приложения и инфраструктуры.
- Нагрузка: модели, точность, контекст, параллельные запросы, объём датасетов и расписание задач.
- Критерии качества: пропускная способность, время до первого токена, задержки p95/p99, допустимые ошибки.
- Комплектация: точные SKU, память, накопители, адаптеры, оптика, топология и версии ПО.
- Инженерные границы: мощность, температурный график, расход, давление и точки подключения.
- Отказы: потеря ввода, насоса, CDU, сетевого канала, узла управления или вычислительного сервера.
- Восстановление: резервные копии, процедура перезапуска, доступ к журналам и ответственность исполнителей.
- Поддержка: запасные части, регламент обслуживания, обучение смены и порядок эскалации.
Заводские испытания подтверждают готовность поставляемого комплекса в согласованной конфигурации. Проверка на площадке подтверждает работу в реальных условиях подключения. Комплексные испытания должны затрагивать границы между подрядчиками: именно там часто остаются невыявленные зависимости.
Пиковую мощность проверяют отдельно от производительности приложения. Энергетический стресс-тест полезен для ввода и охлаждения, но не заменяет тест обучения или инференса. Нужна длительная работа под целевой нагрузкой с регистрацией температур, частот, ошибок, энергопотребления и времени восстановления после предусмотренных событий.
Какие ошибки чаще всего удорожают проект
- Мощность считают только по GPU. Процессоры, память, сеть и инженерные системы также потребляют энергию.
- Ёмкость CDU принимают за готовность площадки. Внешний теплоотвод и параметры контуров остаются отдельными ограничениями.
- Суммируют номиналы резервных блоков питания. Это не даёт фактического потребления и не описывает аварийную схему.
- Не резервируют место под обслуживание. Замена узла, фильтра или насоса требует доступа и безопасной процедуры.
- Расширяют только вычисления. Сеть, хранение, вводы и охлаждение должны расти согласованно.
- Сравнивают сметы по цене одного GPU. Полные затраты включают инфраструктуру, интеграцию и полезную загрузку.
- Не испытывают отказ. Наличие резервного оборудования ещё не подтверждает корректное переключение.
Частые вопросы о модульном ЦОД для ИИ
Можно ли разместить модульный ЦОД на территории предприятия?
Да, если площадка подходит по мощности, связи, основанию, климатическим воздействиям и условиям безопасного обслуживания. До заказа оборудования проверяют точки подключения и пространство под наружные инженерные системы. Сама по себе свободная площадь не подтверждает готовность участка.
Обязательно ли жидкостное охлаждение для любого ИИ-сервера?
Нет. Есть серверы с воздушным охлаждением, а допустимая конфигурация зависит от модели и плотности размещения. Выбирать нужно по тепловой нагрузке всей стойки, условиям помещения и требованиям конкретной платформы. Переделка воздушной системы в жидкостную требует подтверждённой совместимости.
Можно ли начать с одной стойки?
Можно, если она решает начальную задачу и для неё доступна вся необходимая инфраструктура. При планировании следующего этапа заранее оставляют мощность, места подключения, сетевые порты и пространство. Небольшой старт не должен создавать общую точку отказа для будущего комплекса.
Сколько GPU помещается в одной стойке?
В разобранном варианте DigiPowerX — 64 GPU в восьми серверах. Для другого проекта число определяется форм-фактором, питанием, охлаждением, сетью и обслуживанием. Сравнивать стойки только по высоте или количеству ускорителей некорректно.
Нужно ли полностью отказываться от воздушного охлаждения?
Нет. Даже при отводе основной доли тепла жидкостью остаются компоненты и инженерные узлы, которым нужен воздушный контур. Его рассчитывают по остаточной нагрузке, а не исключают из проекта автоматически.
Чем GPU-as-a-Service отличается от покупки оборудования?
При сервисной модели заказчик получает оговорённый вычислительный ресурс и условия доступа. При покупке он приобретает оборудование и берёт на себя согласованный объём интеграции и эксплуатации. В обоих случаях нужно проверить состав услуги или поставки, ограничения, ответственность и полную стоимость.
Какую информацию подготовить для расчёта конфигурации?
Потребуются модели и приложения, целевая производительность, объём данных, режим загрузки, доступная мощность, охлаждение, схема размещения и план расширения. Если часть параметров ещё неизвестна, сначала выполняют пилот приложения и обследование площадки.
Для подбора оборудования Supermicro подготовьте краткое описание нагрузки и условия размещения. С этими данными можно перейти к подбору конфигурации и согласовать серверы, сеть, хранение и инженерные требования в одной спецификации.